Liquid AI выпускает открытые модели принятия решений d1-3B и d1-omni-600M: вероятность вместо токенов
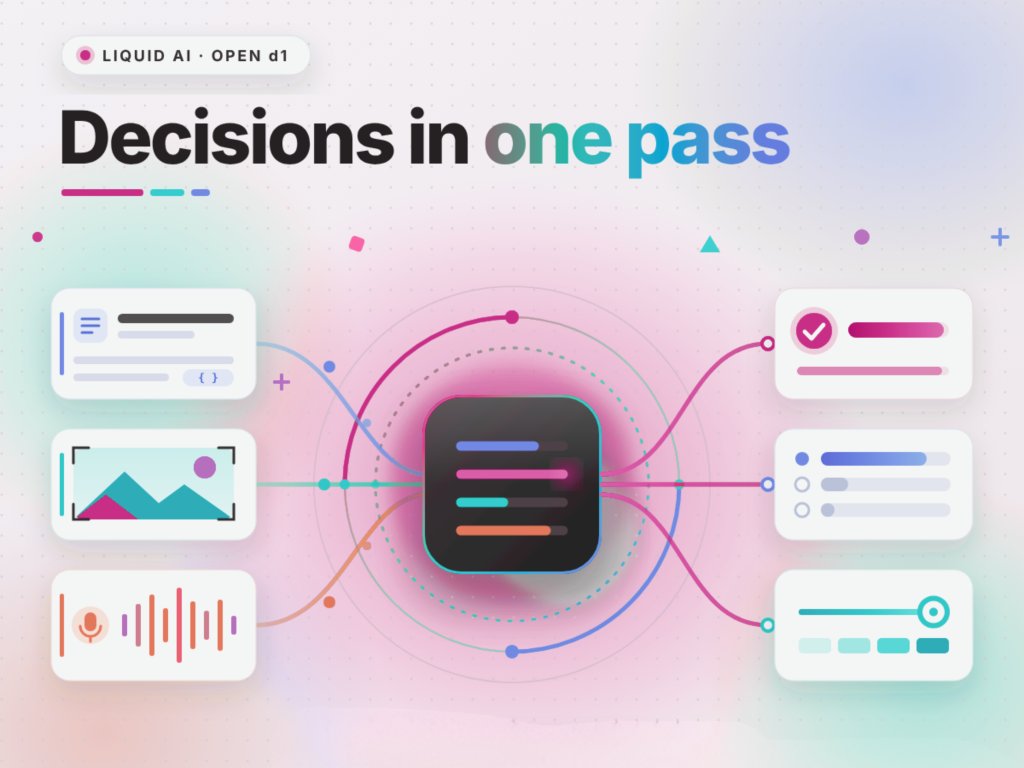
Генеративная LLM пишет ответ токен за токеном, а ваш код его парсит. Модель принятия решений принимает состояние и набор именованных вопросов, читает их один раз и возвращает вероятность для каждого допустимого ответа.
Liquid AI определяет три типа вопросов: noul — вопрос «да/нет», возвращаемый как P(да); choice — одна метка из именованных вариантов с полным распределением вероятностей; score — взвешенная по вероятности позиция на упорядоченной шкале из 2–10 уровней.
Несколько вопросов могут разделять одно состояние за один вызов. Каждый ответ сообщает output_tokens: 0. Liquid AI рекомендует d1 для маршрутизации, модерации, классификации намерений, реранковинга, оценки «LLM-как-судья», защитных ограничителей агента и визуальной инспекции. Оба чекпоинта размещены на Hugging Face, загружаются через Transformers и имеют поддержку llama.cpp с первого дня. Лицензия LFM Open License v1.0 позволяет бесплатное коммерческое использование при годовой выручке ниже $10 млн. d1-omni-600M — ранний исследовательский релиз без опубликованных показателей задержки.
Как построены d1-3B и d1-omni-600M
d1-3B имеет 3,12 млрд параметров и начинается с LFM2.5-VL-3B — декодерной модели зрения и языка. Liquid AI усреднила веса LFM2.5-2.6B с текстовым ядром этой модели, затем донастроила несколько чекпоинтов с разными сидами и смесями данных и снова их объединила. Используется зрительный энкодер SigLIP2 NaFlex на 400 млн параметров и контекст на 32 768 токенов. Длинные входные данные, перемешивание вариантов ответов и исправление «коротких путей» в данных значили больше, чем продвинутые техники.
d1-omni-600M имеет 587 млн параметров и начинается с LFM2.5-Encoder-350M — двунаправленного энкодера. Покрытие: 381 млн общего ствола и головы принятия решений, 94 млн зрительного энкодера и 112 млн аудиоэнкодера. Аудиоэнкодер — FastConformer на 17 слоёв. Контекст — 16 384 токена. Аудиоклипы ограничены 30 секундами. Запрос несёт изображения или аудио, но никогда оба. Обучение аудио охватывало только англоязычные запросы от говорящего к ассистенту.
Где Open d1 подходит лучше всего
Поддержка и триаж тикетов: один вызов d1-3B может ответить на вопрос возврата средств «да/нет», выбрать ответственную команду и оценить срочность по одному и тому же сообщению — с нулевыми токенами для парсинга. Реальное время визуального осмотра и модерации на периферии: d1-3B читает изображение 384px за 35 мс на Jetson AGX Thor, а Arcade от Open d1 запускает его покадрово на живой видеовход для модерации контента и управления жестами.
Производительность на бенчмарках
На Decision Index v0.2.1 d1-3B набирает 48,57. Это превосходит все модели до 10 млрд параметров и обходит Decider 35B-A3B (47,11). Выше только Winnow-12B с 50,02. Liquid AI сама запускала официальный скоррер, поэтому оценки d1 — не заявки в лидерборд. d1-3B лидирует в категориях Tools (74,5) и Arts (36,3), но отстаёт на Knowledge (23,8).
По семи публичным текстовым бенчмаркам d1-3B в среднем даёт 82,9, опережая Decider 4B (81,1). d1-omni-600M в среднем 78,4 и показывает лучшие оценки Civil Comments (95,8) и PAWS-X (79,5). На 11 бенчмарках изображений d1-3B в среднем 74,1 против 73,9 у базовой модели. Liquid AI называет аудио-бенчмарки принятия решений открытой проблемой.
Насколько быстр d1-3B на железе NVIDIA
Liquid AI измеряла сквозную задержку, по одному тёплому запросу за раз. Один вопрос занимает 8 мс на RTX 4090 и 9 мс на AMD MI325X. На Jetson AGX Thor — 16 мс, AGX Orin — 26 мс, Orin Nano — 50 мс. На Jetson AGX Thor три вопроса по одному состоянию занимают 20 мс против 16 мс для одного. Показатель RTX 4090 использует model.compile(mode=’reduce-overhead’); без него один вопрос занимает 16 мс. Jetson AI Lab от NVIDIA также размещает руководства по d1-3B.
Как запустить d1 локально
d1-3B требует transformers>=5.14 и trust_remote_code=True. d1-omni-600M требует transformers>=5.15. Оба предоставляют system_one(state, questions) для одного состояния и system_one_batch для упакованных запросов. Liquid AI рекомендует float16 для d1-omni-600M на GPU, поскольку bfloat16 менял некоторые топ-ответы. Можно опробовать десять демо d1-3B, управляемых камерой, в пространстве Open d1 Arcade.
Ключевые выводы
- Модели d1 выводят вероятности по фиксированным вариантам за один проход, никогда не генерируя токены.
- d1-3B набирает 48,57 на Decision Index v0.2.1 — лучший результат ниже 10 млрд параметров.
- d1-3B отвечает на один вопрос за 8 мс на RTX 4090.
- d1-omni-600M обрабатывает текст с изображениями или аудио при 587 млн параметров.
- Лицензия бесплатна для коммерческого использования ниже $10 млн годовой выручки.