NVIDIA представила Molt — PyTorch-фреймворк агентного обучения с подкреплением
Исследования в области агентного обучения с подкреплением (agentic reinforcement learning) — это бесконечная работа над алгоритмами. Появляются новые оценки, новые стадии пайплайна, новые схемы сбора траекторий. В традиционных фреймворках каждое такое изменение требует правок в слоях тренера, распределённом бэкенде и вспомогательном коде развёртывания. В результате исследователь платит за каждую итерацию дополнительными усилиями и временем.
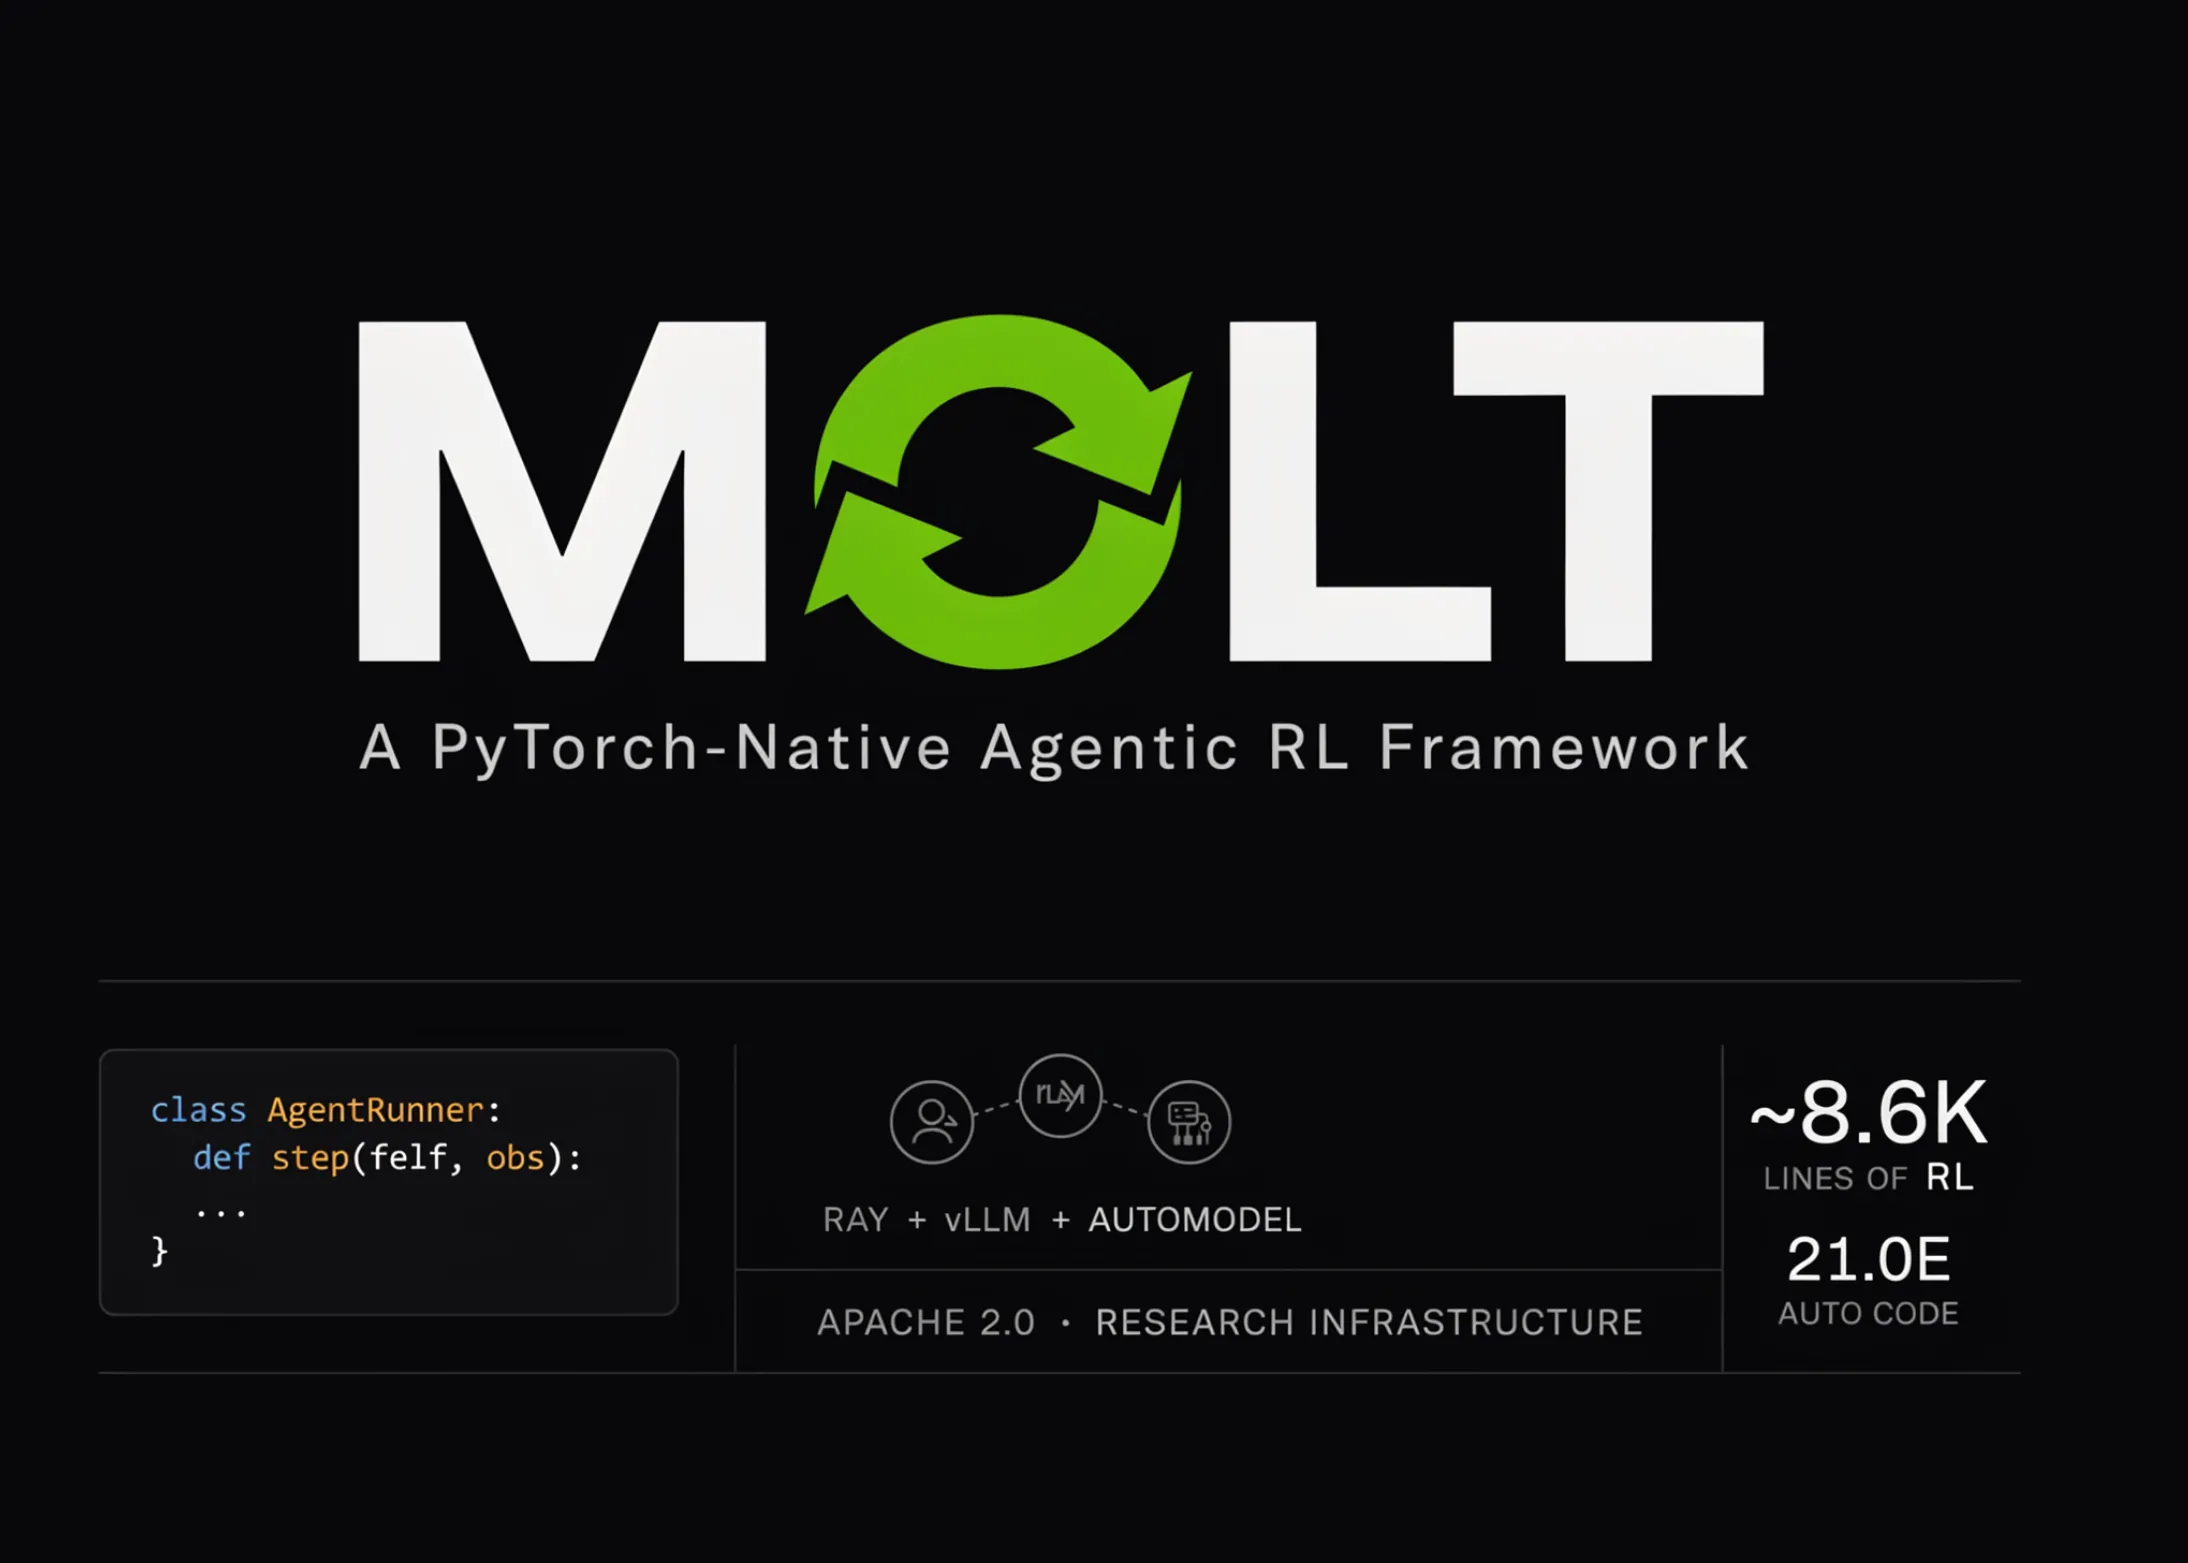
Фреймворк Molt от команды NeMo внутри NVIDIA направлен именно на сокращение этих издержек. Это PyTorch-нативный фреймворк агентного обучения с подкреплением, у которого необычная цель проектирования: кодовая база должна быть достаточно компактной, чтобы исследователь мог удерживать её в голове целиком, а ИИ-ассистент по программированию — прочитать и осмыслить всю целиком. Заявленный объём — примерно 8,6 тысячи строк RL-кода, если считать по графу импортов от точки входа каждого фреймворка. Аналогичный способ подсчёта даёт около 62 тысяч строк для verl, 25 тысяч для slime и 7,2 тысячи для OpenRLHF.
Да, Molt распространяется под лицензией Apache 2.0, вместе с готовыми конфигурациями запуска, скриптами для Slurm и предварительно собранным контейнером. Однако исследовательская статья позиционирует его как инфраструктуру для исследований, а не как производственный сервис обучения. Ключевое ограничение — аппаратное обеспечение. В поставке предполагается использование двух узлов по восемь GPU H100, причём восемь карт выделяются на обучение и ещё восемь — на сбор траекторий.
Это ставит Molt в зону досягаемости передовых и близких к передовым лабораторий, хорошо финансируемых ИИ-стартапов, занимающихся постобучением, корпоративных исследовательских групп в финансах, здравоохранении и робототехнике, которые обучают агентов в собственных закрытых средах, а также академических лабораторий с доступом к многоузловым кластерам H100/H200. Среди возможных применений — многоходовые агенты с использованием инструментов, агенты, исполняющие код, среды «визуальный язык» (в поставке есть рецепт geo3k), циклы вознаграждения, где LLM выступает судьёй, и дистилляция в меньшую студенческую модель по политике (on-policy distillation).
Molt использует Ray для размещения задач и асинхронных очередей, vLLM для сбора траекторий и NVIDIA AutoModel с FSDP2 для обучения. Ни один из трёх компонентов не форкнут, поэтому улучшения из вышестоящих проектов приходят как обновление контейнера, а не как перебазирование собственного кода.
Среда выполнения устроена как пул агентов: набор движков vLLM за маршрутизатором запросов и единственный обучаемый актор-политику. Потоковый пул удерживает группы промптов «в полёте», поэтому движки не простаивают, пока актор обучается. Частичный сбор траекторий приостанавливает движки, рассылает срезы весов актора напрямую по NCCL каждому движку и возобновляет выполнение сохранённых запросов, а не отбрасывает их.
Запуск RL — это один Python-модуль, экспортирующий AgentRunner. Всё остальное — обычный код, включая функцию вознаграждения.
Поддерживаются две формы взаимодействия. В режиме Env фреймворк владеет циклом LLM в шаге step(), выровненном с интерфейсом Gymnasium. В режиме ChatAgent пользователь владеет циклом через стандартный SDK OpenAI или Anthropic. Molt запускает loopback-сервер, который говорит на обоих wire-протоколах, и каждый запрос декодируется на стороне сервера в точное накопление токенов. Когда агент с длинным горизонтом уплотняет контекст и переписывает префикс, сервер автоматически закрывает текущий сегмент и открывает новый.
Три инварианта корректности определяют архитектуру. Идентичность токенов: траекторию определяют идентификаторы сэмплированных токенов, а не повторно токенизированная транскрипция. Семантика версий политики: обучаемые токены сохраняют лог-вероятности поведенческой политики, а асинхронное использование корректируется по каждому токену за последовательностным шлюзом. Согласованность прямого прохода: сбор траекторий и обучение должны совпадать в семантике модели.
Для политик на основе смеси экспертов (mixture-of-experts) последний инвариант важнее всего. Роутеры при сборе и при обучении выбирают экспертов независимо, и небольшие численные различия могут перевернуть top-k выбор. Molt применяет повтор прохождения роутинга (rollout routing replay): vLLM возвращает идентификаторы экспертов для каждого токена, и обучающий прямой проход воспроизводит их.
Таким образом, Molt закрывает существенный пробел в инфраструктуре агентного RL: теперь у исследователей есть компактный, читаемый и полностью прозрачный фреймворк, который можно расширять без необходимости разбираться в тысячах строк распределённого кода. Для сообщества это важный шаг к тому, чтобы эксперименты с агентными алгоритмами стали быстрее и доступнее, а публикуемые результаты — воспроизводимее.
По материалам MarkTechPost