Perplexity раскрыла GPU-стек для эмбеддингов: как сервисы Ivy, Tulip и ROSE обслуживают pplx-embed
Качество поиска в AI-продуктах ограничено двумя факторами: качеством самой модели эмбеддингов и стоимостью её эксплуатации на индексе. На этой неделе инженеры Perplexity опубликовали подробный разбор второго фактора — инфраструктуры, обслуживающей модель pplx-embed и модели ранжирования, используемые в Perplexity Search, Computer и API-платформе.
Команда Perplexity утверждает, что инференс эмбеддингов на GPU практически сошёлся по производительности между движками на зрелом оборудовании Hopper и Blackwell. Главные выигрыши лежат в рантайме и обвязке вокруг модели: управлении CUDA-графами, асинхронной абстракции отслеживания результатов и Rust-пути обработки запросов.
Два типа трафика — один движок
Perplexity рассматривает обслуживание эмбеддингов как две рабочие нагрузки. Пакетные эмбеддинги (batch embedding) возникают при построении или переиндексации векторной базы данных, где пропускная способность минимизирует затраты. Онлайновые эмбеддинги (online embedding) работают в момент запроса, когда короткий запрос должен быть обработан максимально быстро. Между ними — скоринг: после векторного поиска ранжируются большие партии документов, балансируя оба подхода.
Ключевое решение — Perplexity не стала строить отдельный движок эмбеддингов. Поскольку модели эмбеддингов представляют собой небольшие трансформеры, пакетные эмбеддинги напоминают вычислительно ограниченный prefill, а онлайновые (часто лишь несколько токенов) — ограниченный памятью decode. Поэтому исследовательская команда переиспользовала ядра prefill и decode из своего LLM-стека.
Ivy, Tulip и ROSE
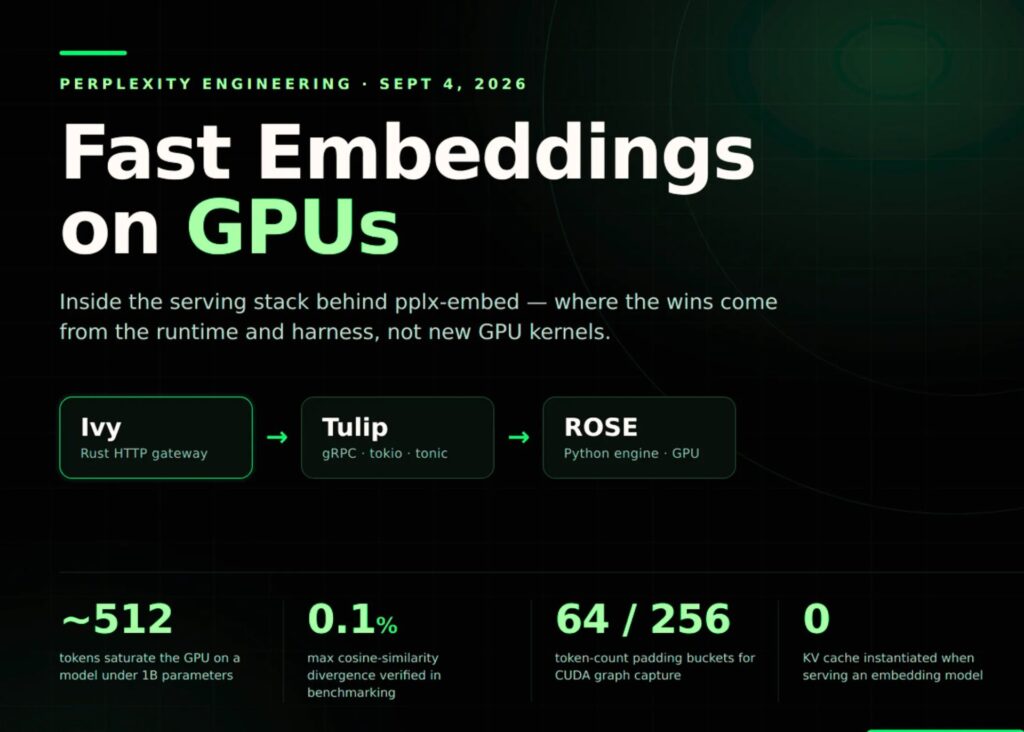
Три сервиса обрабатывают запрос. Ivy — это HTTP-шлюз на Rust. Он выполняет работу на стороне CPU — разбор JSON, токенизацию, шаблонизацию входа, разбиение батчей — и переводит запросы в собственный протокол gRPC. Ivy также разделяет крупные пакетные запросы на части и балансирует их между репликами, исправляя дисбаланс нагрузки, возникающий при изменчивом размере производственных payload’ов.
Tulip — интерфейс инференс-сервера: gRPC-сервер на Rust с tokio и tonic, отвечающий за планирование и батчинг перед отправкой в движок. ROSE (Runtime-Optimized Serving Engine) реализует инференс модели: в основном на Python, предоставляет ядра, слои и определения моделей, управляет CUDA-графами и открывает функции step() для Tulip.
Почему планировщик намеренно прост
Tulip выбирает последовательности в порядке очереди (first-come, first-served), пока накапливаются запросы. Такая простота оправдана измерениями: для небольших моделей эмбеддингов при длинах последовательностей, которые обслуживает Perplexity, линейная стоимость плотных слоёв доминирует над квадратичной стоимостью внимания. Поэтому задержка примерно пропорциональна числу токенов, а не числу последовательностей. Когда батч насыщает GPU — около 512 токенов на модели с менее чем миллиардом параметров — добавление новых последовательностей уже не повышает эффективность.
CUDA-графы и LazyTensors
На небольших батчах запуск ядер на стороне CPU может перевешивать выполнение на GPU. Perplexity строит полномодельные CUDA-графы для всех моделей эмбеддингов, захватывая каждый запуск в единый вызов драйвера. Поскольку модели небольшие, точка перегиба, где работа GPU превышает стоимость запуска, наступает на батчах из тысяч токенов и десятков последовательностей. Некоторые реализации внимания блокируют полномодельные графы, завися от динамических входов на стороне хоста; Perplexity внесла изменения в FlashInfer, чтобы обеспечить захват.
Графы должны захватываться для каждой конфигурации, поэтому количество токенов дополняется до корзин, кратных 64 или 256. Это всё равно даёт тысячи графов и минуты захвата на модель. Решение — отложенный захват (lazy capture): каждая конфигурация получает «прогревочный» запуск, а затем захват и воспроизведение срабатывают при втором обращении. Это стоит p99-задержки при старте, но растягивает минуты «прогрева» на часы.
Вторая часть — LazyTensor, который отслеживает закреплённый в памяти буфер хоста плюс cudaMemcpyAsync и событие CUDA. Вместо блокировки step() на устройстве он возвращает LazyTensor, позволяя асинхронной задаче Rust ожидать батч N, пока CPU ставит в очередь N+1.
Ядра по-прежнему важны
ROSE поддерживает несколько бэкендов внимания для рваных (ragged) входов: FlashInfer 2, FlashInfer 3 и FlashAttention 4. Команда Perplexity сообщает, что FlashAttention 4 в целом быстрее, но FlashInfer 3 превосходит его на моделях на базе Qwen при очень длинных последовательностях, поэтому выбор бэкенда делается индивидуально. Примечательно, что при обслуживании модели эмбеддингов ROSE не создаёт KV-кэш и использует ragged-варианты внимания, чтобы избежать дополнения (padding).
Бенчмарки
Perplexity сравнивает себя с vLLM v0.22.0 в BF16 на реальных весах и входах, полученных из eval, с прогревочными запусками, подтверждающими расхождение косинусного сходства в пределах 0,1%. Отражены четыре набора тестов: низколатентные эмбеддинги (батч 1; 128/512/4096 токенов), низколатентный скоринг (батч 5/25/50 при 512 токенах), высокопроизводительные эмбеддинги (батч 100, четыре параллельных процесса) и высококонкурентные эмбеддинги (от 1 до 16 параллельных запросов, включая токенизацию Ivy и сетевые накладные расходы).
Основные выводы
- Стек эмбеддингов Perplexity переиспользует собственные ядра prefill/decode для LLM, а не запускает отдельный движок.
- Задержка зависит от числа токенов, а не последовательностей; около 512 токенов насыщают модель менее чем с 1 млрд параметров.
- Полномодельные CUDA-графы плюс отложенный захват сокращают накладные расходы запуска без минутного старта.
- LazyTensor перекрывает подготовку CPU-батчей с выполняемой работой GPU вместо блокировки на синхронизации.
- Ivy, Tulip и ROSE — внутренние сервисы; pplx-embed доступен через Embeddings API Perplexity.