GLM-5.3-Flash против Qwen3.8-Flash-Next: два китайских ИИ-лабора независимо пришли к одной архитектуре
На этой неделе в течение суток вышли сразу две передовые модели с открытым весом. Z.ai выпустила GLM-5.3-Flash — мультимодальную MoE-модель на 320 млрд параметров с 18 млрд активных. Команда Qwen из Alibaba представила Qwen3.8-Flash-Next — модель на 125 млрд параметров с 6 млрд активных, которая предваряет архитектуру Qwen4.
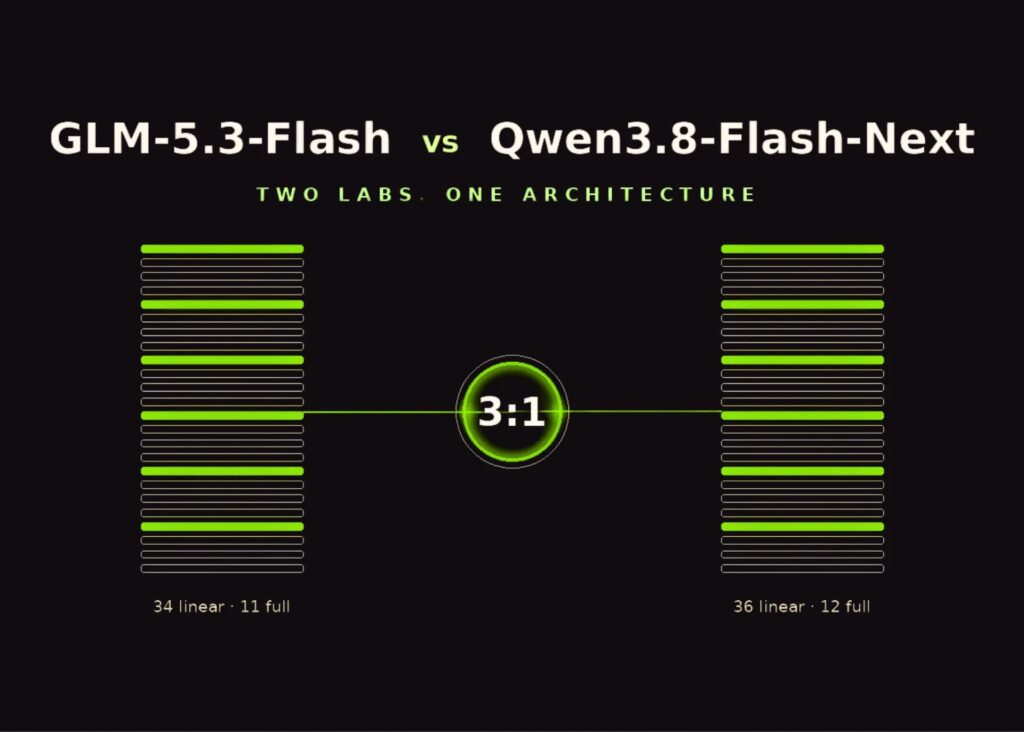
Команды проектировали эти системы независимо. Однако их конфигурации выглядят почти как копии друг друга. Обе используют гибрид линейного и полного внимания в соотношении 3:1. Обе выбирают контекст сжатым индексатором с ограничением в 2048 токенов. Обе расширяют остаточный поток до четырёх управляемых ветвей. Обе обучаются с оптимизатором Muon, с разделением объединённых матриц параметров перед ортогонализацией. Эта статья разбирает общий рецепт, единственную точку разногласия и лабораторию, которая не согласна со всеми.
Кратко о двух релизах
GLM-5.3-Flash — первая нативно мультимодальная модель в серии GLM-5, выпущенная под лицензией MIT на Hugging Face. Z.ai тестировала её анонимно как Ox Alpha на OpenRouter, где она стала самой популярной моделью недели. Модель обучалась на мультимодальном корпусе из 30 трлн токенов и поддерживает контекстное окно в 1 млн токенов. По заявлению Z.ai, она превосходит GLM-5.2 по бенчмаркам при цене в десять раз ниже, приближаясь к Claude Opus 4.8 на задачах кодинга и агентных бенчмарках. Прейскурант: $0,15 за миллион входных токенов и $0,50 за миллион выходных.
Qwen3.8-Flash-Next играет ту же роль, что Qwen3-Next для Qwen3.5: ранняя публичная превью следующего семейства архитектур. В карточке модели указана основная модель на 125 млрд параметров плюс дополнительная таблица n-граммных эмбеддингов на 51 млрд, при этом на токен активируется 6 млрд параметров. Родной контекст — 262 144 токена, расширяемый до 1 млн с помощью YaRN. Команда Qwen сообщает, что обучение потребовало примерно в девять раз меньше вычислений, чем Qwen3.7-Plus. Сопроводительный технический отчёт называется «О проектировании архитектуры Qwen3.8-Next: оценка, эффективность и стабильность обучения».
Точка схождения 1: три из каждых четырёх слоёв внимания — линейные
GLM-5.3-Flash насчитывает 45 слоёв: 34 слоя линейного внимания и 11 слоёв полного внимания, согласно опубликованной конфигурации. Qwen3.8-Flash-Next насчитывает 48 слоёв в повторяющемся блоке из 3 слоёв Gated DeltaNet плюс 1 слой Qwen Sparse Attention, согласно рецепту vLLM. Оба приходят к одному соотношению 3:1.
Линейные слои — это дешёвые слои. Вместо KV-кэша, растущего вместе с текстом, они сжимают всю историю в состояние фиксированного размера. Вычислительная стоимость на токен остаётся постоянной независимо от длины контекста. GLM использует Kimi Delta Attention (KDA) — дизайн линейного внимания, представленный Kimi Linear от Moonshot AI, который применяет тонкозернистый поканальный затухающий гейт. Qwen использует собственный Gated DeltaNet (GDN), гейтирующий на уровне голов. Разная гранулярность гейтирования, одно семейство delta-правил, одна задача.
Оставшаяся четверть слоёв выполняет точный дальний поиск. GLM использует NoPE-внимание с мультиголовыми латентными состояниями (MLA) в стиле DeepSeek. Qwen использует групповое внимание внутри QSA. Именно здесь живёт KV-кэш, и именно здесь применяется второй общий приём.
Точка схождения 2: сжатие в 4 раза, оценка, бюджет 2048 токенов
Ни одна из моделей не позволяет своим слоям полного внимания обозревать весь контекст. Обе используют небольшой обучаемый индексатор, который оценивает фрагменты истории и оставляет только победителей. Параметры почти совпадают.
Разрежённые слои GLM используют 32-головый lightning-индексатор с отбором top-2048, наследующий DSA от DeepSeek. Чтобы снизить стоимость индексатора на контекстах в 1 млн токенов, Z.ai вводит IndexPool, который сжимает четыре векторных ключа индексатора в один через взвешенный пулинг перед оценкой. QSA от Qwen работает на гранулярности микроблоков: сжатый лёгкий индексатор оценивает блоки по 4 токена и оставляет топ-512 блоков — ровно 2048 токенов. Итак, обе модели сжимают контекст в 4 раза перед оценкой, и обе ограничивают бюджет внимания 2048 токенами. Qwen приписывает QSA ускорение до 7,6 раза на этапе prefill и 4,9 раза на декодировании относительно полного внимания при 1 млн токенов.
Совокупный эффект на стороне GLM значителен. По сравнению с полной моделью GLM-5.3, Z.ai сообщает, что архитектура Flash сокращает вычислительные затраты внимания примерно в 3 раза, а размер KV-кэша — в 4,4 раза, почти вдвое уменьшая активные параметры (18 млрд против 32 млрд) и число слоёв (45 против 92).
Точка схождения 3: четыре потока остаточных связей вместо одного
Обе модели отказываются от единого остаточного потока, определявшего трансформеры с 2017 года. Обе расширяют его до четырёх параллельных ветвей, с гейтами, контролирующими, что каждый блок считывает и записывает обратно.
GLM принимает Manifold-Constrained Hyper-Connections (mHC) — дизайн, созданный DeepSeek, с 4 ветвями в опубликованных весах. Qwen написала собственный вариант, Gated Residual, который модулирует поток через 4 расширенных потока с помощью поэлементного гейта чтения, зависящего от данных, и скалярного гейта записи на ветвь. По словам команды Qwen, Gated Residual убирает лишний шаг смешивания ветвей, используемый Hyper-Connections, снижая накладные расходы на доступ к памяти, а гейт достаточно хорошо подавляет выбросы активаций, чтобы позволить хранение остатков в FP8. Примечательно, что команда Qwen абляционно сравнила оба подхода и нашла их примерно равными по качеству. Две лаборатории, две реализации, один идентичный вывод: четыре управляемых потока лучше одного.
Точка схождения 4: Muon с раздельными матрицами
Обе модели обучаются с оптимизатором Muon. И обе применяют одно и то же тонкое улучшение: объединённые проекционные матрицы разделяются на независимые преобразования до того, как Muon их ортогонализирует. Qwen документирует разделение объединённых проекций QKV, SwiGLU и GDN, назначая Muon настоящим двумерным линейным отображениям, а AdamW — эмбеддингам, роутерам и низкоранговым параметрам. Qwen также пересчитала свои законы масштабирования для новой архитектуры и полностью отказалась от разогрева размера батча после того, как измерила, что разогрев стоил на 18,8% больше шагов оптимизатора без улучшения результатов.
Где они расходятся: позиционное кодирование
Единственное чёткое расхождение — ротационные позиционные эмбеддинги в слоях полного внимания. GLM-5.3-Flash от них отказывается: в конфигурации задано qk_rope_head_dim = 0, что делает её разрежённые MLA-слои полностью NoPE. Позиционная информация поступает неявно через рекуррентные линейные слои.
Qwen попробовала то же самое и оставила RoPE. Согласно техническому отчёту Qwen3.8-Next, NoPE не дал измеримой разницы во время предобучения. Сбой проявился позже: после пост-обучения NoPE-вариант часто не мог остановить генерацию. Это полезный предостерегающий результат для всего поля: кривые потерь предобучения могут скрывать поведенческие дефекты, которые проявляются только после настройки в стиле RLHF.
Более широкое схождение и один диссидент
Этот рецепт не ограничивается двумя лабораториями. DeepSeek первым применил паттерн «разрежённый индексатор плюс бюджет 2048» с DSA в DeepSeek-V3.2-Exp, а mHC — дизайн DeepSeek, теперь поставляемый в GLM. Kimi от Moonshot внесла KDA — тот самый слой линейного внимания, который приняла GLM. Китайские открытые модели наглядно перекрёстно опыляются архитектурными компонентами и сходятся к общим настройкам.
Заметный диссидент — MiniMax. При разработке M2 команда широко тестировала линейное и скользящее окно внимания в масштабе и обнаружила серьёзные дефициты в многошаговых рассуждениях, особенно за пределами 32K контекста после SFT. M2 вышла с полным softmax-вниманием в каждом слое. Для M3 MiniMax приняла MiniMax Sparse Attention (MSA), которая разреживает softmax-внимание через отбор блоков, но вообще не содержит слоёв линейного внимания. Так что поле ещё не устоялось. Z.ai, Qwen, DeepSeek и Kimi ставят на то, что гибрид 3:1 сохраняет рассуждения. Абляции MiniMax говорят, что нет, по крайней мере для их стека.
Ключевые выводы
- GLM-5.3-Flash (34:11) и Qwen3.8-Flash-Next (36:12) независимо пришли к одному соотношению линейного и полного внимания 3:1.
- Обе сжимают контекст в 4 раза и ограничивают разрежённое внимание бюджетом в 2048 токенов — паттерн, начатый DSA от DeepSeek.
- Обе заменяют единый остаточный поток четырьмя управляемыми ветвями; Qwen абляционно сравнила свой Gated Residual с mHC и нашла их равными.
- Расходятся в позиционном кодировании: GLM отказывается от RoPE (NoPE), а Qwen оставила его после того, как NoPE-модели не могли остановить генерацию после пост-обучения.
- MiniMax — диссидент: его масштабные абляции показали, что линейное внимание вредит многошаговым рассуждениям, поэтому M3 использует только разрежённое softmax-внимание.