Google DeepMind выпустила EmbeddingGemma 2: модель эмбеддингов на 740 млн параметров для текста, кода, изображений и видео
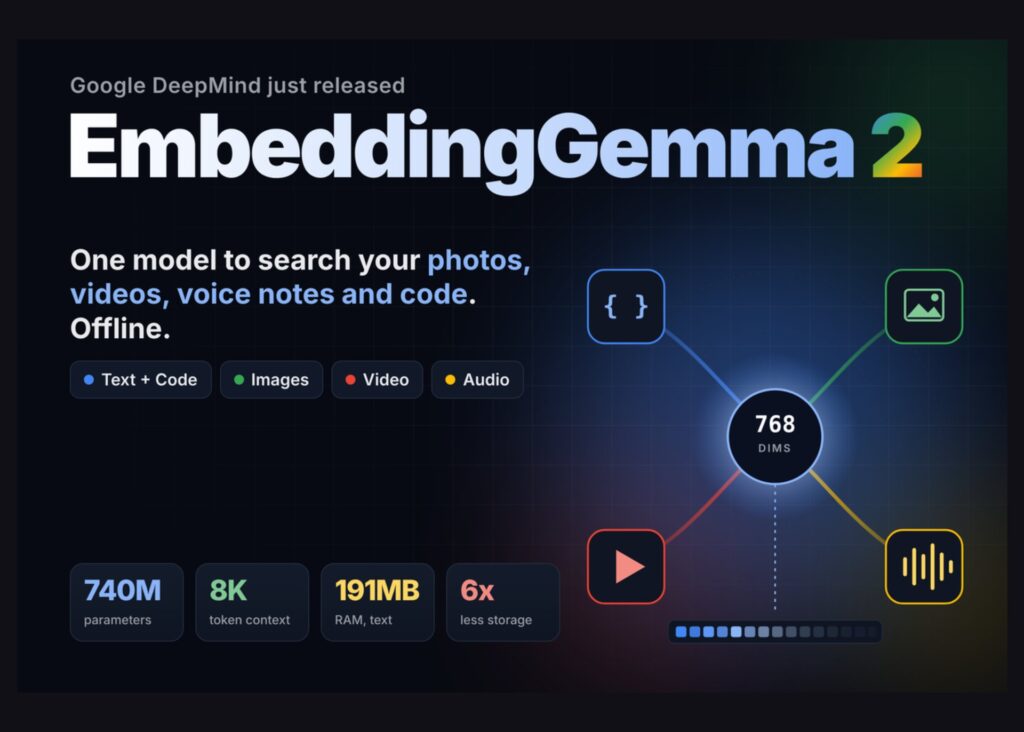
Модель выпущена под лицензией Apache 2.0 и уже доступна на Hugging Face и Kaggle, а также содержит сборки для Ollama, llama.cpp GGUF и LiteRT.
Что делает модель эмбеддингов
Модель эмбеддингов преобразует контент в вектор чисел, отражающий смысл. Похожие элементы оказываются рядом, что упрощает поиск и сравнение. В конвейере RAG такие векторы позволяют LLM извлекать свежую информацию, на которой она не обучалась. Генерация эмбеддингов локально хранит данные на устройстве, снижает задержку и работает офлайн.
Одно векторное пространство для всех модальностей
EmbeddingGemma 2 построена на архитектуре Gemma 4. Текстовый запрос может найти фотографию. Голосовая заметка — найти видеоклип. Перемежающиеся входные данные, например карточка товара с текстом, изображениями и демонстрационным видео, дают единый эмбеддинг.
Конструкция модульная, из трёх частей:
- Текстовая и кодовая основа: 270 млн параметров (трансформер 130 млн + эмбеддер 140 млн)
- Зрительный энкодер: 170 млн параметров, опционально
- Аудиоэнкодер: 300 млн параметров, опционально
Разработчики загружают только то, что нужно: 270 млн для текста, 440 млн для текста и зрения, 570 млн для текста и аудио или 740 млн для всего. Все конфигурации используют одно векторное пространство. Запрос, внедрённый чисто текстовой конфигурацией, может сопоставиться с документами, внедрёнными полной моделью.
Контекстное окно — 8192 токена, в 4 раза больше версии 1. Оно вмещает около 29 изображений, 58 видеокадров или 5,5 минут аудио.
Бенчмарки
Исследовательская группа Google сообщает о лидирующих показателях среди мультимодальных эмбеддеров до 1 млрд параметров на MTEB Code и MAEB. Результаты в полной точности, 768 измерений:
Извлечение кода выигрывает 9,92 пункта, примерно 14%. Мультиязычное качество текста остаётся стабильным. Более крупные модели по-прежнему лидируют в ряде таблиц. Qwen3-VL-Embedding-2B сообщает о 73,2 в собственном прогоне MMEB-V2 при примерно в 2,7 раза большем числе параметров и без поддержки аудио.
Создано для телефонов и ноутбуков
При квантовании на Pixel 11 Pro активная оперативная память составляет около 191 МБ для чисто текстовых весов. Полная мультимодальная модель требует около 567 МБ. Обучение с учётом квантования сжимает веса до INT4 и INT8. Команда Google AI Edge измерила 37,3 мс на изображение на GPU MacBook M5 Pro с бюджетом зрения в 70 токенов.
Обучение представлений типа Matryoshka (MRL) позволяет разработчикам усекать векторы до 512, 256 или 128 измерений. Переход с 768 на 128 измерений сокращает хранилище до 6 раз. При 256 измерениях мультиязычный MTEB снижается всего с 61,36 до 60,41. При 128 измерениях MMEB падает до 45,65, поэтому Google рекомендует 128 измерений в основном для чисто текстовых нагрузок.
Как запустить
Модель работает на sentence-transformers v6.1.0+, Transformers, vLLM, SGLang, MLX, llama.cpp, Ollama, LM Studio, LiteRT и MediaPipe. Qdrant покрывает векторное хранение, а Unsloth — тонкую настройку. Поддержка ML Kit для Android с ускорением NPU появится в течение нескольких недель.
Установка: pip install -U «sentence-transformers[image,audio,video]» transformers. На Ollama — ollama pull embeddinggemma-2. Теги варьируются от 270m (378 МБ) до 740m (1,3 ГБ). Демо — в галерее Google AI Edge.
Ключевые выводы
- Одна открытая модель на 740 млн параметров внедряет текст, код, изображения, видео и аудио в общее пространство на 768 измерений.
- Модульные энкодеры масштабируют размер от 270 млн (текст) до 740 млн (полная мультимодальность).
- Извлечение кода скачет с 68,76 до 78,68 на MTEB Code.
- Работает в диапазоне ~191–567 МБ оперативной памяти на Pixel 11 Pro с квантованием.
- Можно ли использовать EmbeddingGemma 2 в коммерции? Да, лицензия Apache 2.0.
- Сколько памяти нужно? Google сообщает о ~191 МБ активной RAM для текста и 567 МБ для полной мультимодальности на Pixel 11 Pro при квантовании.