NVIDIA выпустила Nemotron 3 Diarization: открытая модель на 100 млн параметров различает 8 голосов в реальном времени
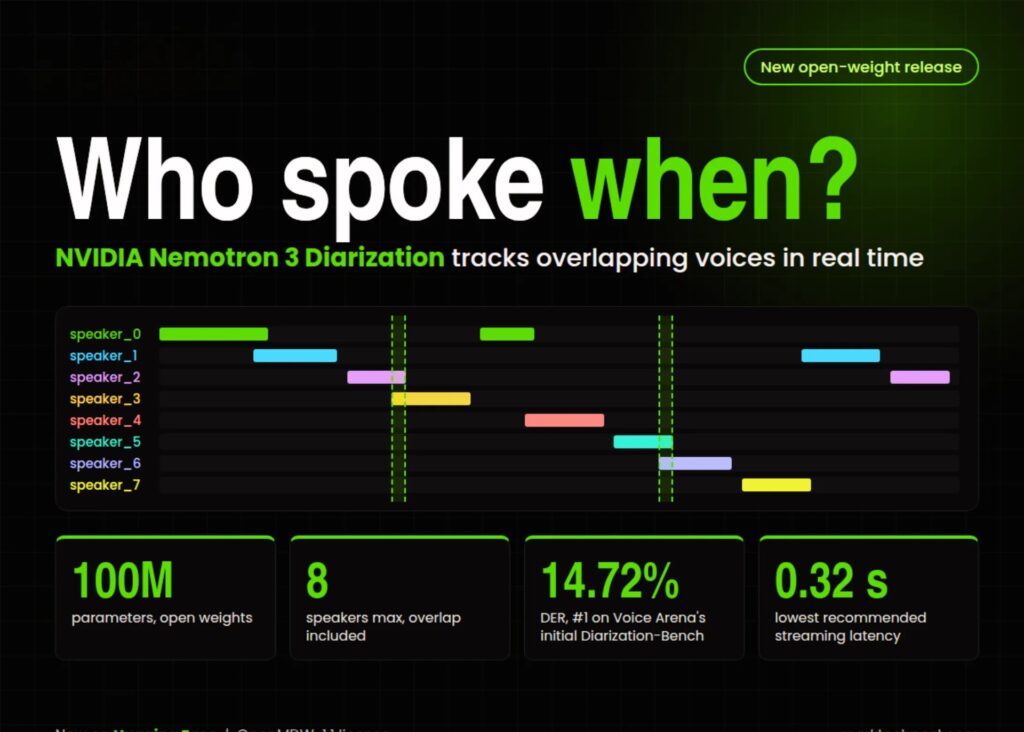
NVIDIA выпустила Nemotron 3 Diarization — открытую по весам модель диаризации говорящих на Hugging Face. Она отвечает на один вопрос о любом разговоре: кто говорил и когда. Модель на 100 миллионов параметров различает до 8 голосов, в том числе когда речь накладывается. Один чекпойнт работает и с офлайн-записями, и с потоковой передачей в реальном времени.
Можно ли это развернуть? Да. Веса опубликованы под лицензией OpenMDW License 1.1, допускающей коммерческое использование. Модель работает под Linux через NVIDIA NeMo на GPU Ampere, Ada Lovelace, Hopper или Blackwell.
Зачем нужна диаризация говорящих?
Автоматическое распознавание речи (ASR) даёт слова, но не говорит, кто их произнёс. Без атрибуции система суммаризации не может определить, кто взял обязательство или кто высказал возражение.
Диаризация выдаёт временные интервалы активности каждого говорящего. Эти метки времени вместе с выводом ASR дают транскрипт с привязкой реплик к спикерам. Инструменты для встреч, аналитика звонков, обработка подкастов и память голосовых агентов — всё это зависит от данного шага.
Что изменилось по сравнению со Streaming Sortformer
Более ранний потоковый чекпойнт NVIDIA diar_streaming_sortformer_4spk-v2.1 поддерживал 4 говорящих. Nemotron 3 Diarization удваивает этот предел до 8. По данным анонса NVIDIA, цель — сложное аудио многосторонних разговоров, где люди говорят одновременно.
Как устроена архитектура
Модель принимает одноканальное аудио 16 кГц в форматах .wav, .flac, .opus или .mp3. Аудио преобразуется в признаки Mel-спектрограммы с шагом 10 мс. Признаки объединяются с коэффициентом 8, что даёт кадры кодера по 80 мс.
Эти кадры обрабатывает 31-слойный трансформерный кодер с ротационными позиционными эмбеддингами (RoPE). Затем слой Conv1D повышает разрешение предсказаний обратно до 10 мс. На выходе — тензор [T, 8] вероятностей активности по каждому говорящему.
Такая схема напрямую работает с наложением: если двое говорят одновременно, в одном кадре активируются два канала.
Модель следует подходу Sortformer, упорядочивая говорящих по времени появления. Первый новый голос занимает канал 1, следующий — канал 2 и так далее. Это сохраняет метки стабильными между потоковыми фрагментами, поэтому модели не нужно заново сопоставлять говорящих с каналами на каждом куске.
В потоковом режиме используются два механизма памяти. Кэш говорящих в порядке появления (AOSC) сохраняет информацию о голосах из предыдущих фрагментов, а очередь FIFO даёт контекст последних кадров. Метки анонимны, а их привязку к реальным личностям оставляют приложениям.
Четыре режима задержки
Задержка входного буфера равна сумме длительности фрагмента и правого контекста, умноженной на 80 мс. В таблице использованы DER по полному набору DIHARD III и пропускная способность при компиляции с батчем 32 из карточки модели.
Эта задержка не учитывает вычисления, сеть и время ASR. Технически модель может работать с буфером 80 мс, но 0,32 с — минимальная рекомендованная настройка.
Результаты бенчмарков
В начальных результатах Diarization-Bench от Voice Arena модель заняла первое место среди 12 систем и 17 конфигураций. Тест охватывал 139 англоязычных разговоров общей длительностью около 22 часов. Она показала DER 14,72% против 19,3% у следующей системы — примерно на 24% лучше в относительном выражении. NVIDIA отмечает, что результаты могут измениться после завершения оценки Version 1 в Voice Arena.
По сравнению с базовой моделью на 4 говорящих при задержке 1,04 с DER снизился во всех восьми условиях оценки. Относительное улучшение составило от 9,0% на CALLHOME-Part2 до 65,2% на NOTSOFAR1 MHM. Невзвешенное среднее по восьми условиям — 41,0%.
Есть и одно ухудшение. На двухговорящем CALLHOME при 30,4 с DER вырос с 5,68% до 5,98%. При этом полный набор CALLHOME-Part2 всё равно улучшился: с 10,32% до 9,10%.
Пропускная способность тоже выросла. При 30,4 с модель достигла 15 113× RTFx против 2619× у базовой версии. Тесты проводились в BF16 на NVIDIA RTX PRO 5000 с torch.compile(). Это показатели пакетной обработки, а не задержка потока в приложении.
Обучающие данные
Для обучения объединили около 10 000 часов реальных разговоров и 82 611 часов смоделированных смесей множества говорящих. В смесь вошло и реальное многоспикерное аудио, лицензированное у David AI. Добавление данных David AI снизило составной DER с 11,19% до 10,42%. Лицензированное исходное аудио для смоделированных смесей охватывает 21 язык.
Как начать
Установите NVIDIA NeMo Speech с Python 3.12 или новее.
Выходные сегменты имеют вид start end speaker_id. Чтобы получить и слова, объедините модель с Parakeet TDT 0.6B v3, следуя руководству по интеграции с ASR.
Живая демонстрация Space предлагает синтетические разговоры, живой микрофон, многоязычный живой микрофон и загрузку аудио. Для продакшена NVIDIA указывает Baseten и DigitalOcean. Поддержка на устройствах доступна через Argmax Pro SDK 3. Через Hugging Face Inference Providers модель пока недоступна.
У модели есть ограничения. В записях с более чем 8 говорящими речь может пропускаться или приписываться не тому человеку. Сильный шум, реверберация и запись на большом расстоянии тоже повышают частоту ошибок.
Главное
- Открытая модель на 100 млн параметров различает до 8 накладывающихся голосов.
- Один чекпойнт покрывает всё — от офлайн-обработки (30,4 с) до сверхнизкой потоковой задержки 0,32 с.
- Первое место в начальном Diarization-Bench от Voice Arena с DER 14,72%.
- В среднем 41,0% относительного снижения DER по сравнению со Streaming Sortformer при 1,04 с.
- Лицензия OpenMDW-1.1 допускает коммерческое использование; модель работает на GPU NVIDIA через NeMo.