Qwen выпустила голосовую модель Qwen-Audio-3.1-Realtime, которая думает, действует и сама решает, когда вступать в разговор
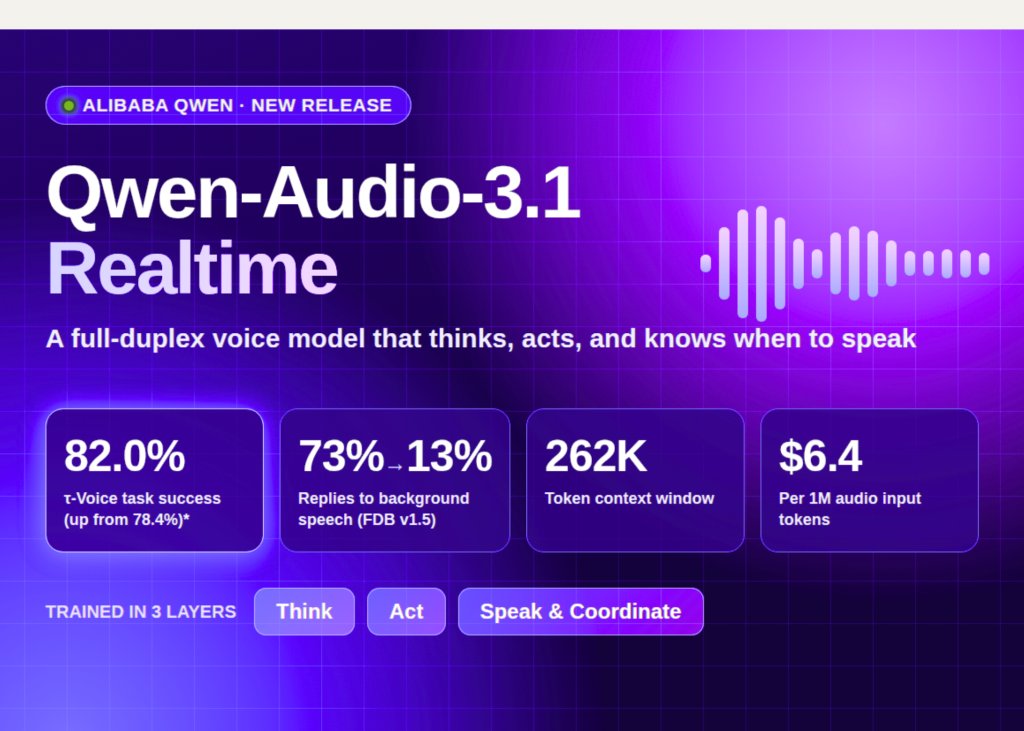
Команда Qwen из Alibaba представила линейку Qwen-Audio-3.1 — набор из пяти аудиомоделей, охватывающий распознавание речи, синтез и взаимодействие в реальном времени. Флагманом семейства стала Qwen-Audio-3.1-Realtime: полнодуплексная речевая модель, рассчитанная на голосовых агентов, которые вызывают внешние инструменты. Заодно компания объявила о снижении цен — примерно на 85% для Realtime, порядка 70% для синтеза речи и до 95% для распознавания.
Можно ли развернуть её у себя? Да, но только в виде управляемого API. Модель qwen-audio-3.1-realtime-plus уже работает в QwenCloud через WebSocket. Открытые веса при этом не публиковались.
Согласно карточке модели, она принимает и выдаёт как текст, так и звук. Размер контекста — 262 тыс. токенов, максимум на входе — 245 тыс., на выходе — 16 тыс. По умолчанию действуют лимиты в 60 запросов и 100 тыс. токенов в минуту. Тарифы: $6,4 за 1 млн входных аудиотокенов и $0,8 за 1 млн входных текстовых токенов. Выдача текста и звука стоит $24 за 1 млн токенов, причём генерация именно текстового ответа не тарифицируется. Среди ключевых возможностей заявлены вызов функций, поиск в интернете, структурированные ответы, кеш контекста и дообучение.
Ещё одна модель семейства, Qwen-Audio-3.1-ASR-Flash-Filetrans, создана для офлайн-транскрибации длинных записей. Она умеет работать со списками ключевых слов, разделять говорящих, расставлять знаки препинания, а также распознавать речь на множестве языков и китайские диалекты. Стоимость — $0,15 за 1 млн токенов на входе и $0,47 на выходе.
Архитектура: две модели за одним голосом
В основе системы работают две модели, построенные на одинаковом аудиокодере и одной и той же большой языковой модели. Полнодуплексная решающая модель предсказывает, продолжать ли слушать, заговорить, замолчать или возобновить речь. Модель распознавания оформляет содержание ответа в виде текста. Затем учитывающий контекст голосовой рендерер превращает этот текст в потоковую речь, опираясь на историю диалога, голосовые сигналы и акустическую обстановку.
Обучение разбито на три уровня: «Думать», «Действовать», а также «Говорить и координировать».
На этапе Core-Cocktail SFT аудиомодель заново привязывают к её исходной текстовой языковой модели, используя парные данные объёмом в миллионы часов. Дальше следует мультимодальное OPD. Текстовый учитель вместе с замороженным аудиоэталоном оценивают каждый токен собственной траектории ученика. Речь идёт о дистилляции на собственной политике, а не о подражании заранее написанным ответам. Затем с помощью GRPO обучают экспертов по эмпатии, прагматическим интенциям и акустическим сценам. Наконец, Multi-Teacher OPD сводит их в одну модель, готовую к развёртыванию.
Действие: исполняемые среды
Каждый тренировочный домен объединяет в себе набор инструментов, базу данных JSON с сохранением состояния и бизнес-правила, записанные естественным языком. Домены формируются на основе определений инструментов из открытых источников и конфигураций серверов MCP. Любая задача предполагает ровно один из трёх исходов: запись, обоснованный отказ или запрос, который система не поддерживает. Проверка идёт по порядку — сначала итоговое состояние, затем допустимые записи, потом утверждения о поведении. Красивый и беглый ответ не спасёт положение, если проверка состояния провалилась.
Награду в GRPO модель получает на трёх уровнях: диалога, промежуточных вех и отдельной реплики. При обучении поиску лишние запросы штрафуются по формуле r query = q min(1, n ref / n pred). Среднее число запросов на один вызов поиска упало с 4,37 до 1,05. При этом показатель Trigger F1 просел с 60,87% до 58,61%.
Именно этот уровень решает, стоит ли вообще говорить, в какой момент и каким образом. В бенчмарке Full-Duplex-Bench v1.5 доля ответов на реплики, адресованные другому собеседнику, снизилась с 0,13 до 0,03. На версии v3.0 доля слов-заполнителей сократилась с 0,7590 до 0,2960. Однако без компромиссов не обошлось: после перебивания частота нежелательного возобновления речи выросла с 0,035 до 0,130. Задержка остановки при перебивании составляет 1,116 секунды против 0,383 у GPT-Realtime-2.
Разберитесь, как устроен цикл «думать — действовать — говорить», как принимаются дуплексные решения, как выглядит учебный эпизод с оценкой и как рассчитывается награда за поиск.
По сравнению с версией 3.0 результат в Audio MultiChallenge поднялся с 47,12 до 52,21. Средний балл BBA по 14 языкам вырос с 81,7% до 88,1%. Метрика WER в FLEURS упала с 9,01 до 3,98. Показатели τ-Voice получены на полудуплексной адаптации распознавания речи, поэтому напрямую сравнивать их с официальными результатами полного дуплекса нельзя. А вот в исследовании «красной команды» с участием 50 сессий GPT-Realtime-2 по-прежнему впереди: 96,00% против 92,00%.
Указанные цены — это прайсовые значения, проверенные 28 сентября 2026 года. Тарифы за токены нельзя сопоставлять напрямую: каждый провайдер разбивает аудио на токены по-своему.
- Успешность решения задач в адаптации τ-Voice выросла с 78,4% до 82,0% относительно версии 3.0.
- Доля ответов на фоновую речь в Full-Duplex-Bench v1.5 уменьшилась с 73,0% до 13,0%.
- Контекст 262 тыс. токенов, вызов функций и поиск в интернете при цене $6,4 за 1 млн входных аудиотокенов.
- Работа с инструментами обучается методом GRPO внутри саморазвивающихся исполняемых сред.
- Успешность многоходовых атак падает до 26,0% для китайского языка и 23,5% для английского.
- Что такое Qwen-Audio-3.1-Realtime? Это полнодуплексная речевая модель команды Qwen из Alibaba, предназначенная для голосовых агентов, которые рассуждают, вызывают инструменты и управляют очерёдностью реплик.
- Можно ли развернуть её самостоятельно? Открытые веса не публиковались. Доступ открыт только через API QwenCloud под именем qwen-audio-3.1-realtime-plus.
- Сколько это стоит? $6,4 за 1 млн входных аудиотокенов и $24 за 1 млн выходных токенов для текста и звука.