Reka выпускает Rho-1: 19B-модель всестороннего рассуждения, которая понимает, генерирует видео и выводит действия роботов
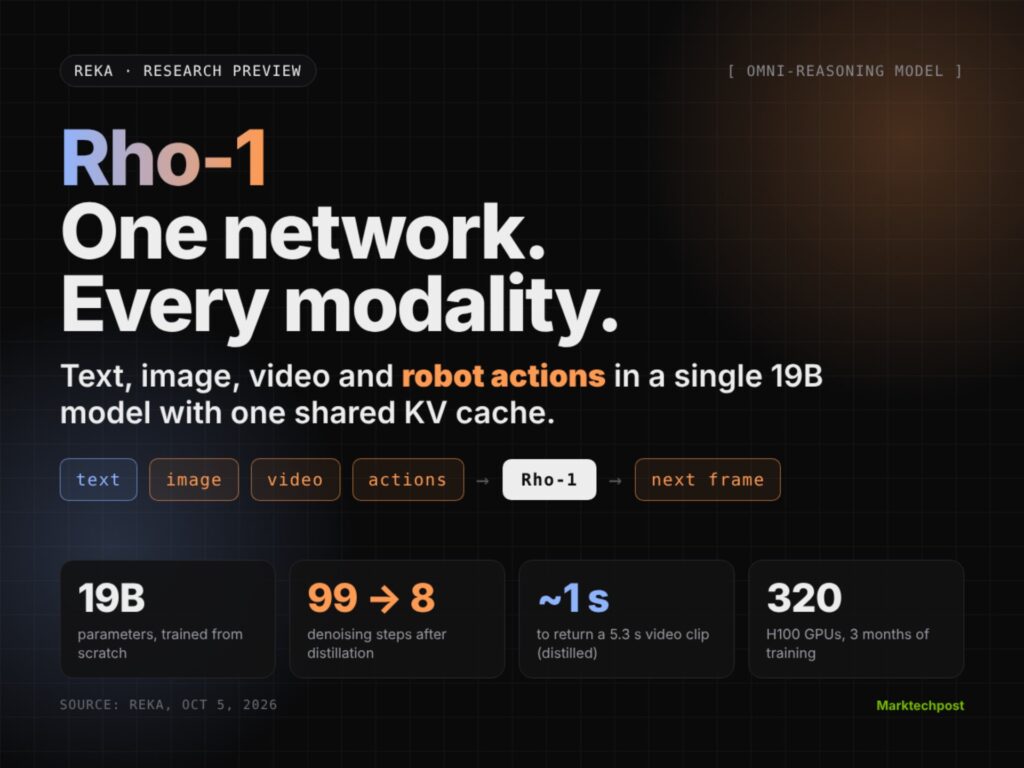
Reka выпустила исследовательский превью-доступ к Rho-1 — 19-миллиардной модели всестороннего рассуждения, обученной с нуля. Единая нейронная сеть понимает и генерирует текст, изображения и видео, рассуждает над ними и выводит действия роботов. Reka позиционирует её как прямую замену агентным пайплайнам, которые передают работу между моделями, специализирующимися на отдельных модальностях.
Что меняет Rho-1
Большинство современных мультимодальных систем — это пайплайны. Центральная модель планирует, затем передаёт задачи специалистам по изображениям, видео или детекции. Каждый переход добавляет задержку, и каждый специалист видит только узкий запрос.
Rho-1 устраняет эти переходы. Текст, visión и роботизированные действия становятся токенами внутри одного контекстного окна. Согласно исследованию Reka, один неотредактированный сеанс демонстрирует полный цикл. Модель рисует маяк, заключает его в рамку, анимирует, редактирует видео, добавляя снежную бурю, и объясняет разницу. Всё это происходит за 5 ходов, без вызова инструментов и без второй модели.
Архитектура: два потока, один кэш KV
Все входные и выходные данные используют один из двух родных форматов:
Дискретные токены переносят текст, символическое рассуждение и высокоуровневые команды.
Непрерывные токены переносят латентные представления изображений, кадры видео, действия роботов и проприоцепцию.
Каждый трансформерный блок содержит два потока весов экспертов. Поток понимания обрабатывает язык и визуальный парсинг. Поток генерации денизирует латентные представления в изображения и видео. Оба потока разделяют внимание и работают над одним и тем же кэшом KV.
Когда ответу нужны пиксели, поток понимания испускает дискретный токен передачи. Поток генерации затем рендерит из полного накопленного состояния. Обучение сочетает предсказание следующего токена для дискретных последовательностей с flow matching для непрерывных выходов.
Эта конструкция имеет практические последствия. Ограничивающие прямоугольники выходят как координатные токены, а не от отдельного детектора. Первый кадр видео переиспользует внутриконтекстное представление изображения вместо повторно закодированной копии.
Скорость: базовая против дистиллированной
Базовая модель генерирует видео со скоростью 0.79x от реального времени (медиана), а читаемый поток начинается примерно через 6 секунд. Команда Reka измерила 7,0 секунд до первого клипа против иллюстративных 13,8 секунд для мультиагентного пайплайна.
Дистиллированный вариант сокращает денизинг со 99 шагов до 8, с минимальной потерей качества, по их словам. Он вернул 5,3-секундный клип примерно за секунду. Во внутренних тестах Reka он соответствовал самым быстрым специализированным моделям изображений. Он также был самой быстрой моделью по времени до первого текстового токена. Это тесты, проведённые вендором, а не независимые бенчмарки.
Мир-модель и робототехника
Rho-1 непрерывно выводит поток, клип за клипом. Новые инструкции поступают через поток понимания и обновляют состояние посередине rollout. Reka демонстрирует одно начало, разветвляющееся на продолжения «bank left» и «bank right».
Для робототехники действия и будущие кадры декодируются из одного латентного состояния. Эпизод симуляции LIBERO показывает Rho-1, испускающую 7 каналов действий. Чтобы масштабироваться за пределы скудных логов телеоперации, Reka сочетает Rho-1 со своей Inverse Dynamics Model, которая выводит управляющие сигналы из исходного видео.
Сравнение Rho-1 с аналогами
Данные проверены 5 октября 2026 года из официальных источников.
| Характеристика | Reka Rho-1 | ByteDance BAGEL | BAAI Emu3.5 | Google Genie 3 |
|---|---|---|---|---|
| Разработчик | Reka | ByteDance Seed | BAAI | Google DeepMind |
| Параметры | 19B | 14B всего, 7B активных (MoT) | 34B | Не раскрыто |
| Входы | Текст, изображение, видео, действия, проприоцепция | Текст, изображение | Чередующийся текст и изображение | Текстовый запрос, входы навигации |
| Выходы | Текст, изображение, видео, действия, проприоцепция | Текст, изображение | Чередующийся текст и изображение | Интерактивный видеомир |
| Нативная генерация видео | Да, ограничено 672×384 | Нет | Нет (кадры изображений, не нативные клипы) | Да, 720p при 24 кадрах/с |
| Управление в реальном времени | Да, непрерывные rollout | Нет | Нет | Да, управляемые события мира |
| Действия роботов | Нативные непрерывные токены действий | Нет | Демонстрации манипуляций в теле | Принимает навигационные действия, но не выводит их |
| Открытые веса | Нет | Да, Apache 2.0 | Да, Apache 2.0 | Нет |
| Доступ сегодня | Исследовательский превью через [email protected] | Hugging Face, GitHub | Hugging Face, приложение emu.world | Project Genie для подписчиков Google AI Ultra |
| Источник / Ресурсы | Блог Reka | GitHub | Hugging Face | Блог DeepMind |
Доступ к Genie 3 через Project Genie; количество параметров Emu3.5 согласно его карточке на Hugging Face.
Ключевые выводы
- Rho-1 — это 19B-модель, которая читает и записывает текст, изображения, видео и действия роботов.
- Два экспертных потока разделяют внимание и один кэш KV в каждом блоке.
- Дистилляция сокращает денизинг со 99 до 8 шагов, около 1 секунды на клип длиной 5,3 секунды.
- Обучена на 320 H100 в течение 3 месяцев; видео ограничено разрешением 672×384.
- Только исследовательский превью: пока нет публичных весов, API или цен.
Ознакомьтесь с техническими деталями и анонсом в X. Вся благодарность принадлежит исследователю этого проекта.