Станут ли мозговые волны следующим ключом к физическому AI?
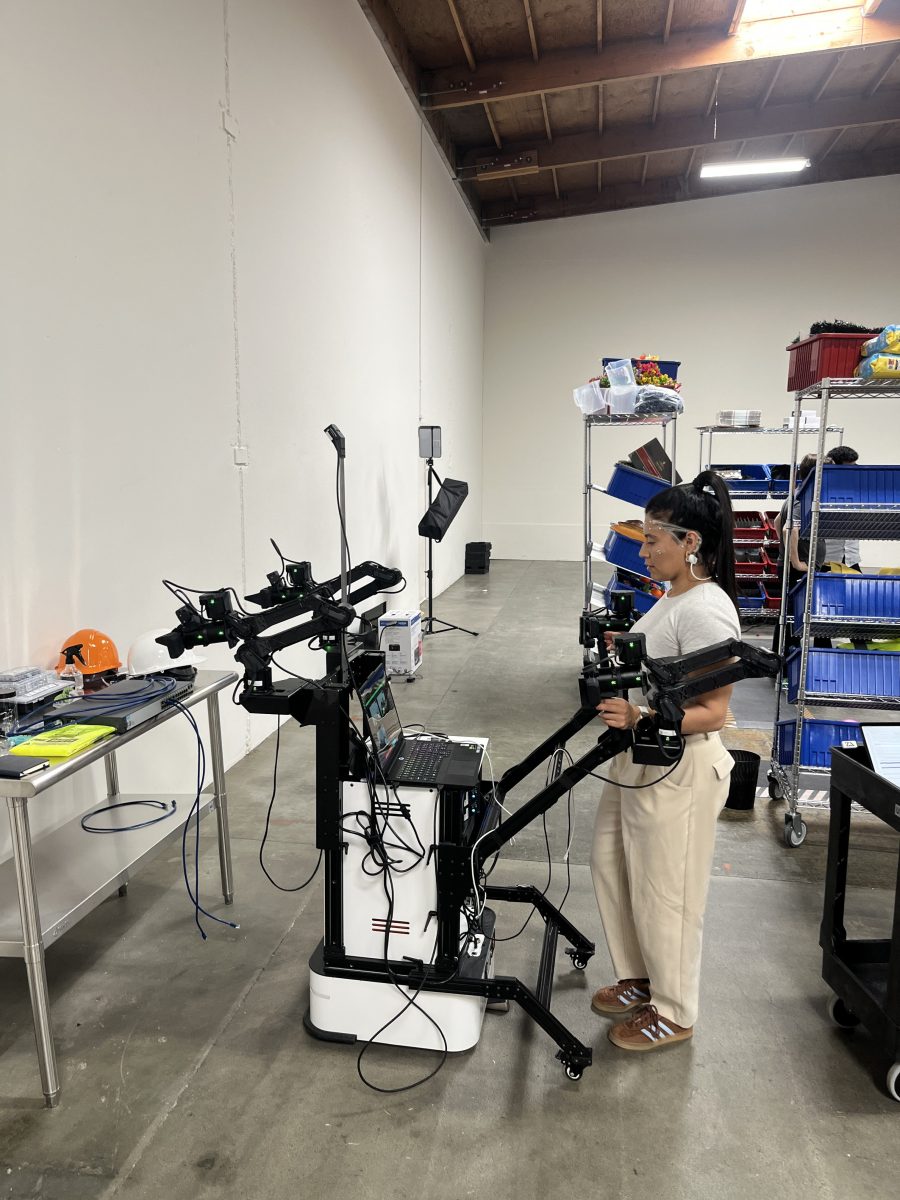
Передний край физического AI — это игра в Дженгу на складе в Сан-Леандро, Калифорния. Этот склад занимает компания Encord, которая создаёт инструменты обработки данных для обучения AI-моделей. Эндрю Сеха — пилот, как в компании называют своих операторов роботизированных тренажёров, — осторожно вытаскивает деревянные блоки из шатающейся башни, надев гарнитуру с камерой, отслеживающей то, что он видит. Само по себе это довольно обычно для сбора данных для обучения роботов, но эта гарнитура включает датчики, измеряющие его мозговые волны, пока он аккуратно разбирает башню из блоков.
Encord — один из небольшого, но растущего числа стартапов, делающих ставку на то, что следующим реальным ограничением для человекоподобных и складских роботов будет не архитектура моделей, а острая нехватка реальных физических данных для обучения. Вместо того чтобы просто помогать робототехническим компаниям управлять имеющимися данными, Encord строит бизнес вокруг создания данных, которых у них нет.
Гарнитура для измерения мозговых волн, которую носит Сеха, была создана Zander Labs — немецким нейротехнологическим стартапом, который делает ставку на то, что измерение мозговой активности для определения психических состояний, таких как ошибка, намерение и удивление, может создать более полезный набор данных для обучения моделей. Текущая работа Encord с Zander является пилотным проектом; компания планирует собрать первоначальный набор данных с разметкой мозговых волн, прогнать его через клиентские робототехнические модели и оценить, действительно ли он улучшает производительность.
Лукас Герке, нейробиолог Zander, наблюдающий за работой, объясняет, что уровень мозговой активности в любой момент выполнения задачи даёт подсказки разработчикам моделей, пытающимся понять, когда нужно задействовать наиболее ресурсоёмкие модели. Это позволяет оптимизировать вычислительные ресурсы и повысить эффективность работы AI-систем в реальных условиях.
По словам Винита Велмуругана, руководителя отдела обучения роботов Encord, это «передовая линия» усилий по решению проблемы узкого места в данных для робототехники. Ветеран робототехнической лаборатории OpenAI и Berkshire Grey, Велмуруган присоединился к Encord для создания внутренней команды по генерации данных.
Encord была основана для помощи компаниям, создающим приложения машинного зрения, в аннотировании данных и оценке моделей. Когда их клиенты начали применять сквозное обучение к задачам роботизированных манипуляций, руководители поняли, что им придётся самим создавать обучающие данные, а не просто управлять ими. «Таких данных просто не существует», — сказал Велмуруган.
Ставка на то, что генеративный AI может сделать для роботов то же, что он сделал для чат-ботов, продолжает наталкиваться на эту же стену. Компании, занимающиеся беспилотными автомобилями, собирают данные из реального мира самостоятельно, но это сложно масштабировать. Обучение на видео может работать, но ему не хватает точности данных реального мира. По словам Велмуругана, потребуется набор данных примерно в пять раз больше видеокорпуса YouTube, чтобы прорваться — масштаб, который помогает объяснить, почему генерация данных сама по себе стала бизнесом, а не просто исследовательской задачей.
Компании, создающие «мозги» для роботов, теперь обращаются к двум основным источникам: «эгоцентричное» видео, собираемое работниками с камерами, часто дополненное дополнительными углами обзора, и данные от роботов, управляемых удалённо. Encord делает и то, и другое, собирая эгоцентричные данные с нескольких заводов по всему миру и используя своё предприятие в Сан-Леандро для экспериментов с новыми модальностями, такими как мозговые волны.
Во время визита TechCrunch пилоты использовали установки «лидер-последователь» — парные роботизированные манипуляторы, один из которых управляется человеком-оператором, а второй повторяет его движения — для создания данных о таких задачах, как разливание кофе из кофейника в чашки и складывание фишек для покера. «Каждая компания по созданию человекоподобных роботов просила нас об этих данных», — говорит Велмуруган.
Ещё одна новая модальность данных, которую разрабатывает Encord, использует набор датчиков, закреплённых на предплечье, для обнаружения электрических сигналов в мышцах. Видео, снятое человеческими руками, манипулирующими объектами, обычно не захватывает всю кисть, и Велмуруган надеется построить 3D-изображение положения руки в любой момент времени на основе датчиков на руке.
Наборы данных Encord аннотируются физическими описаниями того, что содержит каждое видео — «правая рука затягивает болт» — чтобы помочь моделям на основе LLM понимать происходящее. Велмуруган оценивает, что такая плотная аннотация стоит в 100 раз больше, чем «мусорные эгоцентричные данные» для обучения конкретным задачам.
Но «в 100 раз больше» — это всё ещё реальные деньги, и в этом загвоздка: извлечение текста из интернета, как это делали создатели LLM, практически ничего не стоило передовым лабораториям. Генерация физических данных для обучения — нет, и это ограничение сравнения физического AI с LLM. Такие данные должны быть произведены, а не просто собраны, и это меняет экономику создания этих моделей.
Велмуруган говорит, что прогресс достигается — благодаря доступу к программам по всей индустрии он видит, как стартапы и передовые лаборатории выясняют, что работает, а что нет. Эта точка обзора, находясь между множеством робототехнических компаний одновременно, также является частью предложения Encord. Компания может определить, какие методы работы с данными набирают обороты во всей индустрии, раньше, чем любой отдельный клиент.
По материалам TechCrunch